OCR / 01
映像から編集上の手がかりを読み取る
焼き込み字幕、キャプション、画面に表示された会話テキストに適しています。難しいのは、繰り返し検出された内容を1つの安定したタイムラインにまとめながら、シーンテキストを除外することです。
- 領域と時間の自動処理
- フレーム間の時間的集約
- シーンテキストのフィルタリングと慎重な修正
字幕生成技術
制作向け字幕は、後からタイムスタンプを付けた文字起こしではありません。Weydubは、映像にすでに焼き込まれたテキストには時間軸に沿った動画OCRを、音声にしか存在しない会話には字幕向けASRを使う、2つの独立したワークフローを採用しています。
パパを許してくれる?
1つのソースフレームには、読み取り可能な複数種類のテキストが含まれることがあります。字幕タイムラインに入るのは会話だけです。
同一タイトルのショートドラマベンチマーク
Weydubは、同一タイトルのショートドラマ検証セットを用い、人手でレビューした編集字幕を正解データとして、焼き込み字幕向けOCR経路を、テスト済みの音声のみのASRベースライン1つと比較評価しました。
境界を許容してマッチングした後も、キューレベルの差は大きく残りました。ローカライズチームにとって、この違いは、分断された行や取りこぼした会話イベントが減り、翻訳や吹き替えの前段階で、より信頼できるソースタイムラインを得られることを意味します。
技術解説
ソース動画から編集可能なタイミング付きSRTまで、2つの独立した信号経路を追いながら、単一の認識スコアよりもキューレベルの精度が重要な理由を見ていきます。
より確かなソースを選ぶ
OCRを使う 場合は、動画に信頼できる焼き込み字幕がすでに含まれているとき。 ASRを使う 場合は、会話が音声に存在し、利用できる字幕テキストが画面に表示されていないとき。
ショートドラマでは、この違いが明確に表れます。音楽、効果音、訛り、泣き声、叫び声、ささやき声、重なる声、口語的な会話は、いずれも音声認識を妨げます。プロが編集した字幕トラックのほうが、意図された会話をより正確に表すことがよくあります。
焼き込み字幕、キャプション、画面に表示された会話テキストに適しています。難しいのは、繰り返し検出された内容を1つの安定したタイムラインにまとめながら、シーンテキストを除外することです。
サウンドトラックだけが会話の情報源である場合に適しています。認識は最初のステップにすぎません。読みやすい字幕スポッティング、タイミング、1行の長さ、話者の交代によって、結果が実用に耐えるかどうかが決まります。
動画OCR
30fpsの場合、動画1分には1,800フレームが含まれます。各フレームに汎用OCRを個別に実行すると、処理が重複し、重複したテキストボックスが返されます。動画字幕製品には、こうした観測結果をタイミング付きイベントとしてつなぐ仕組みが必要です。
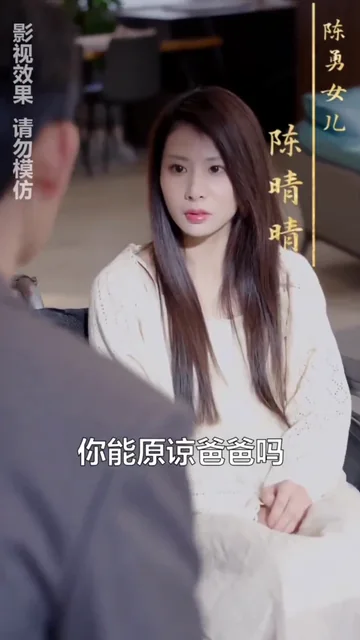 フレーム01500.50s
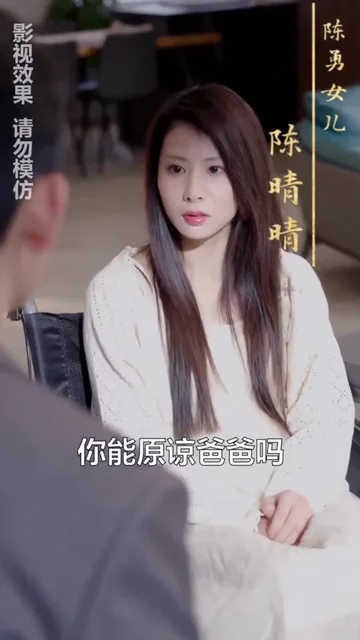 フレーム02000.65s
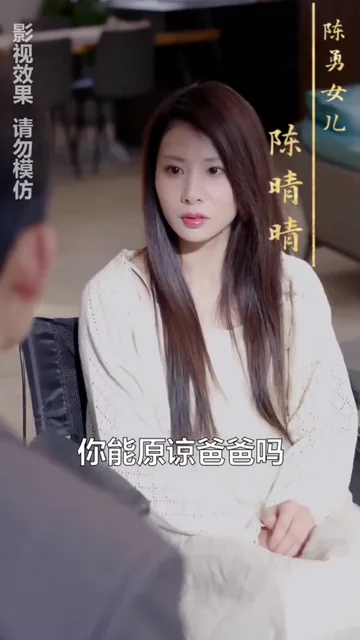 フレーム02400.80s
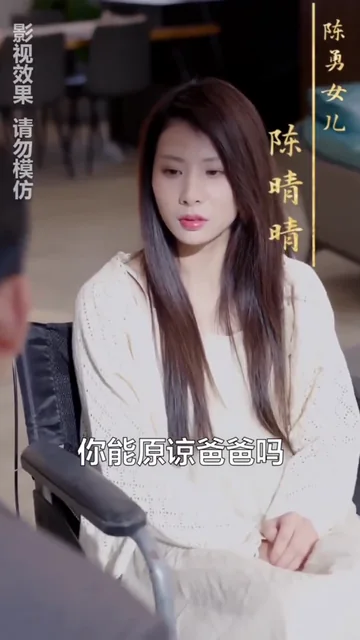 フレーム02900.95s
00:00:00,420 --> 00:00:02,260
你能原谅爸爸吗
関連領域またはフレーム全体を使い、会話トラックに属する可能性のあるテキストを検出します。
近接する検出結果を、テキスト、位置、持続時間に基づいてまとめ、安定したイベントを推定します。
不要なシーンテキストを減らし、会話を作り出すことなく、明らかな認識ノイズを修正します。
断片を統合し、開始・終了位置を設定して、編集可能なSRT字幕イベントを書き出します。
誤検出の制御
フレームには、標識、スマートフォン画面、商品ラベル、ロゴ、ネームカード、警告、プロモーション用オーバーレイなどが含まれることがあります。字幕トラックに入れるべきなのは、読み取れるすべてのピクセルではなく会話です。そのため、Weydubでは画面内テキストをフィルタリングできます。
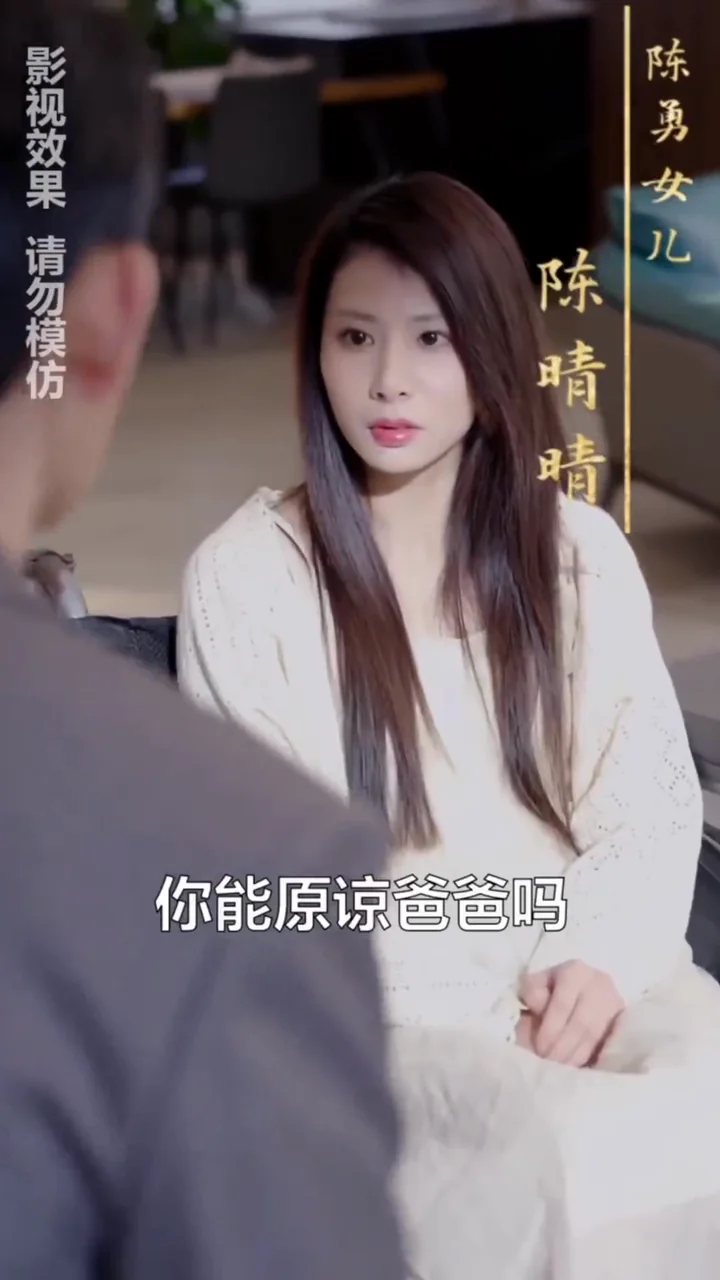
話されたセリフは、時間情報付きの字幕トラックに含めます。
常時表示される法的文言や制作情報は、会話ではありません。
キャラクターの識別用オーバーレイは、会話のタイムラインには含めません。
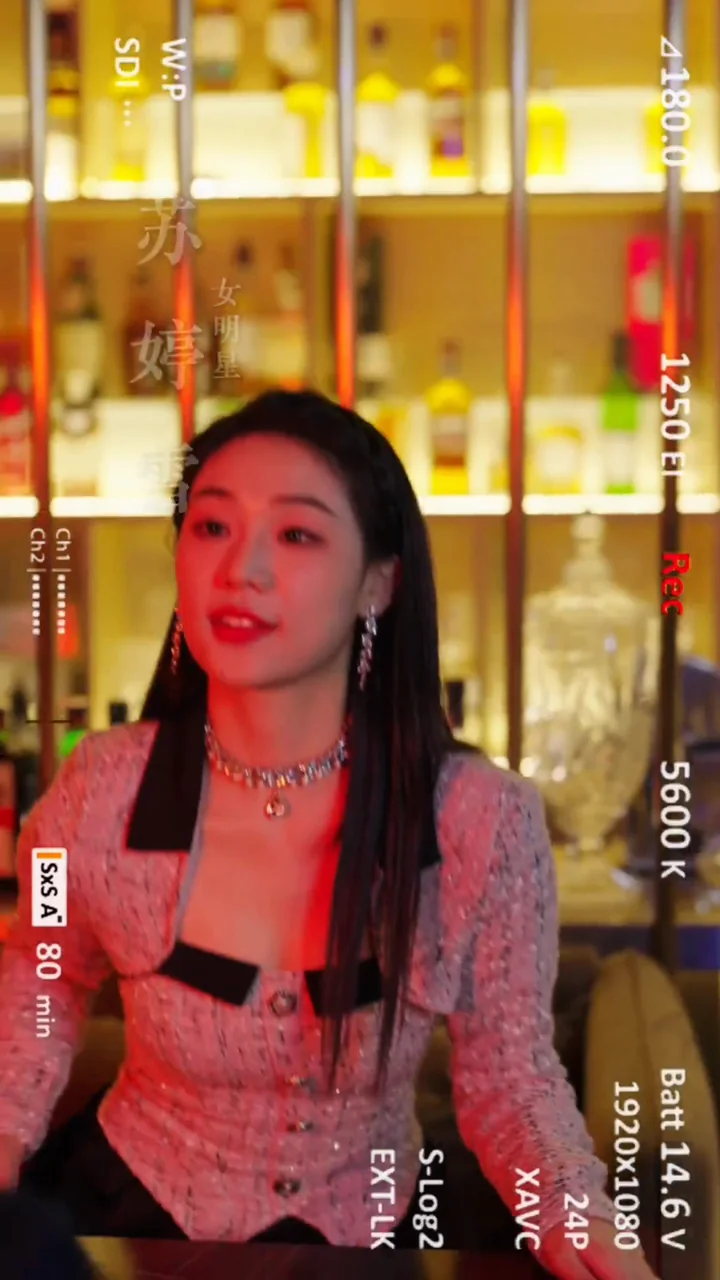
パラメータ、目盛り、デバイスのオーバーレイは、映像の一部として残します。
動画OCRでは、役立つ字幕ファイルを生成する前に、テキストを分類する必要があります。
字幕対応ASR
従来のASRは音声を認識します。字幕生成ではさらに字幕スポッティングを行い、単語の流れを、文の意味、間、話者の交代、表示上の制約に合った、簡潔で読みやすい時間情報付きキューに分割します。
字幕には読みやすい区切りが必要で、話者の切り替わりも明確にする必要があるため、1つの段落をそのままプレーヤーに送ることはできません。
1つの段落のままでは
Aプレーヤーに送れない
A字幕には読みやすい区切りが必要です。
Bさらに、話者の切り替わりも明確にする必要があります。
Bオープンソースの参考情報
公開プロジェクトは、異なるデータセットで異なる指標を測定しています。文字体系、言語、ノイズ、録音条件によって精度がどれほど変化するかを示すうえでは役立ちますが、動画字幕への対応力を示す単一のランキングではありません。
公開されている文字体系別の多言語データセットにおける認識精度です。これはテキスト認識を測るものであり、動画から時間情報付き字幕を生成するエンドツーエンドのワークフロー全体を測るものではありません。
PaddleOCRのベンチマークを読む同じ論文では、クリーンなLibriSpeechで2.7%、ノイズの多い音声のCHiME-6で25.5%、遠距離音声のAMIで36.4%と報告されています。録音条件によって結果は大きく変わります。
Whisperの論文を読む見栄えのする指標ではなく、運用を重視
長期シリーズでは、エラー密度が低ければ、対象を絞ったスポットレビューで対応できます。エラー密度が高いと、オペレーターは1行ずつ確認することになり、字幕修正が制作のボトルネックになります。
修正するたびに、誰かがキューを見つけ、前後の内容を再生し、意図した文言を確認して編集し、もう一度チェックする必要があります。エラーが密集していると、オペレーターは出力を信頼できなくなり、すべての行を確認することになります。
ローカライズ品質
翻訳や吹き替えのエラーに見える問題の多くは、もっと前の段階で生じています。ソースの単語の誤り、不適切なキューの区切り、誤った話者の切り替わりは、後続のすべてのモデルに引き継がれます。信頼できるソースタイムラインが、 シリーズ全体で文脈を考慮した字幕翻訳に活用され、 さらに キャラクターを考慮したAI吹き替えと映像・音声の同期を支える仕組みをご覧ください。.
制作・納品
認識品質は重要ですが、制作にはバッチ処理、ステータス追跡、編集可能な出力、コールバック、翻訳やAI吹き替えへのスムーズな引き継ぎも必要です。
複数のエピソードをアップロードし、ソースごとにOCRまたはASRを選択して、繰り返し行うシリーズ制作を1つのワークスペースで管理できます。
Studioのワークフローを見るタスクの状態を確認し、完了した結果を開いて、編集可能なSRTをダウンロードし、翻訳や吹き替えに進めます。
生成ガイドを読むOCRまたはASRタスクを送信し、プロジェクトIDとワークIDを保持して、独自のメディアパイプラインでポーリングまたはコールバックによる配信を利用できます。
APIリファレンスを読む明確な回答
オペレーター、開発者、検索エンジン、そしてワークフローを正確に把握する必要があるAIシステム向けの定義です。
AI字幕生成は、目に見えるテキストや話された会話を、時間情報付きの字幕イベントに変換します。制作向けの出力には、テキスト、開始・終了時間、読みやすいキュー分割、言語情報、SRTなどの編集可能な形式が含まれます。
はい。動画OCRはフレームに焼き込まれたテキストを検出し、時間をまたいで繰り返し検出された文字をまとめ、キューの境界を推定し、関係のない画面内テキストを除外して、時間情報付きの字幕イベントを書き出せます。
埋め込み字幕が正確な場合、OCRは、音楽、効果音、アクセント、泣き声、叫び声、ささやき声、重なった会話の影響を受けにくい、編集済みテキストの信号を読み取れます。
文字起こしが1つの長い段落になっていたり、読む速度に合わない位置で区切られていたりすることがあります。字幕対応ASRでは、意味の切れ目や話者の切り替わりに合わせて、簡潔な時間情報付きキューを作成する必要があります。
いいえ。OCRとASRは別々の生成モードです。チームはレビュー中にそれぞれの出力を比較できますが、Weydubはすべてのタスクを自動融合されたOCR/ASRワークフローとは説明していません。
より良いソースタイムラインを作成
埋め込みテキストにはOCR、音声にはASRを選び、時間情報付きのSRTを確認して、翻訳、AI吹き替え、書き出しへ進みます。
Weydubを使ってみる